主题
HTML 、HTTP 、web 综合问题
1. 前端需要注意哪些 SEO
- 合理的
title、description、keywords:搜索对着三项的权重逐个减小,title值强调重点即可, 重要关键词出现不要超过 2 次, 而且要靠前,不同⻚⾯title要有所不 同;description把⻚⾯内容高度概括, ⻓度合适,不可过分堆砌关键词,不同⻚⾯description有所不同;keywords列举出重要关键词即可 - 语义化的
HTML代码,符合W3C规范:语义化代码让搜索引擎容易理解网⻚ 重要内容HTML代码放在最前:搜索引擎抓取HTML顺序是从上到下, 有的搜索引擎对抓 取⻓度有限制,保证重要内容⼀定会被抓取 - 重要内容不要用
js输出:爬虫不会执⾏ js 获取内容 - 少用
iframe:搜索引擎不会抓取iframe中的内容 - ⾮装饰性图片必须加
alt - 提高网站速度: 网站速度是搜索引擎排序的⼀个重要指标
2. <img> 的 title 和 alt 有什么区别
- 通常当鼠标滑动到元素上的时候显示
alt是<img>的特有属性, 是图片内容的等价描述,用于图片⽆法加载时显示 、读屏器 阅读图片 。可提图片高可访问性, 除了纯装饰图片外都必须设置有意义的值, 搜索引擎会 重点分析。
3. HTTP 的几种请求方法用途
GET⽅法发送⼀个请求来取得服务器上的某⼀资源
POST⽅法向 URL 指定的资源提交数据或附加新的数据
PUT⽅法跟 POST ⽅法很像,也是想服务器提交数据 。但是, 它们之间有不同 。
PUT指定了资源在服务器上的位置, 而 POST 没有
HEAD⽅法只请求页面的首部
DELETE⽅法删除服务器上的某资源
OPTIONS⽅法它用于获取当前 URL 所⽀持的⽅法 。如果请求成功,会有⼀个 Allow 的头包含类 似 “GET,POST” 这样的信息
TRACE⽅法TRACE ⽅法被用于激发⼀个远程的,应用层的请求消息回路
CONNECT⽅法把请求连接转换到透明的 TCP/IP 通道
4. 从浏览器地址栏输入 url 到显示页面的步骤
基础版本
- 浏览器根据请求的
URL交给DNS域名解析,找到真实IP, 向服务器发起请求; - 服务器交给后台处理完成后返回数据, 浏览器接收⽂件 (
HTML、JS、CSS、图象等); - 浏览器对加载到的资源 (
HTML、JS、CSS等) 进行语法解析, 建立相应的内部数据结构 ( 如HTML的DOM); - 载⼊解析到的资源⽂件, 渲染页面, 完成。
详细版
在浏览器地址栏输⼊ URL
浏览器查看缓存, 如果请求资源在缓存中并且新鲜,跳转到转码步骤
- 如果资源未缓存,发起新请求
- 如果已缓存,检验是否足够新鲜, 足够新鲜直接提供给客户端, 否则与服务器进行验 证。
- 检验新鲜通常有两个 HTTP 头进行控制 Expires 和 Cache-Control :
- HTTP1.0 提供 Expires,值为⼀个绝对时间表示缓存新鲜⽇期
- HTTP1.1 增加了 Cache-Control: max-age=,值为以秒为单位的最大新鲜时间 2/115
浏览器解析 URL 获取协议, 主机,端⼝ , path
浏览器组装⼀个 HTTP ( GET) 请求报文
浏览器获取主机 ip 地址, 过程如下:
- 浏览器缓存
- 本机缓存
- hosts ⽂件
- 路由器缓存
- ISP DNS 缓存
- DNS 递归查询 ( 可能存在负载均衡导致每次 IP 不⼀样)
打开⼀个 socket 与目标 IP 地址,端口建立 TCP 链接,三次握手如下:
- 客户端发送⼀个 TCP 的
SYN=1,Seq=X的包到服务器端⼝ - 服务器发回
SYN=1,ACK=X+1,Seq=Y的响应包 - 客户端发送
ACK=Y+1,Seq=Z
- 客户端发送⼀个 TCP 的
TCP 链接建立后发送 HTTP 请求
服务器接受请求并解析,将请求转发到服务程序, 如虚拟主机使用工 TTP 工 ost 头部判断请 求的服务程序
服务器检查 HTTP 请求头是否包含缓存验证信息如果验证缓存新鲜, 返回 304 等对应状态码
处理程序读取完整请求并准备工 TTP 响应, 可能需要查询数据库等操作
服务器将响应报文通过 TCP 连接发送回浏览器
浏览器接收工 TTP 响应,然后根据情况选择关闭 TCP 连接或者保留重用,关闭 TCP 连接的四 次握手如下:
- 主动⽅发送
Fin=1,Ack=Z,Seq=X报⽂ - 被动⽅发送
ACK=X+1,Seq=Z报⽂ - 被动⽅发送
Fin=1,ACK=X,Seq=Y报⽂ - 主动⽅发送
ACK=Y,Seq=X报⽂
- 主动⽅发送
浏览器检查响应状态吗:是否为 1XX, 3XX, 4XX, 5XX, 这些情况处理与 2XX 不同
如果资源可缓存, 进行缓存
对响应进⾏解码 (例如
gzip压缩)根据资源类型决定如何处理 (假设资源为工 TML ⽂档)
解析
HTML文档,构件DOM树,下载资源,构造CSSOM树,执行js脚本, 这些操作没有严 格的先后顺序, 以下分别解释构建
DOM树:- Tokenizing:根据工 TML 规范将字符流解析为标记
- Lexing:词法分析将标记转换为对象并定义属性和规则
- DOM construction:根据工 TML 标记关系将对象组成 DOM 树
解析过程中遇到
图片 、样式表 、js ⽂件,启动下载构建
CSSOM树:- Tokenizing:字符流转换为标记流
- Node:根据标记创建节点
- CSSOM:节点创建 CSSOM 树
根据
DOM树和CSSOM树构建渲染树:- 从 DOM 树的根节点遍历所有可见节点,不可⻅节点包括:
- script , meta 这样本身不可⻅的标签 。
- 被 css 隐藏的节点, 如 display: none
- 对每⼀个可⻅节点,找到恰当的 CSSOM 规则并应用
- 发布可视节点的内容和计算样式
- 从 DOM 树的根节点遍历所有可见节点,不可⻅节点包括:
js解析如下:- 浏览器创建 Document 对象并解析 HTML,将解析到的元素和文本节点添加到文档中,此 时 document.readystate 为 loading
- HTML 解析器遇到没有 async 和 defer 的 script 时,将他们添加到文档中,然后执⾏⾏内 或外部脚本 。这些脚本会同步执⾏, 并且在脚本下载和执⾏时解析器会暂停 。这样就可 以用 document.write()把文本插⼊到输⼊流中 。同步脚本经常简单定义函数和注册事件 处理程序,他们可以遍历和操作 script 和他们之前的文档内容
- 当解析器遇到设置了 async 属性的 script 时, 开始下载脚本并继续解析文档 。脚本会在它 下载完成后尽快执行,但是解析器不会停下来等它下载 。异步脚本禁止使用 document.write(), 它们可以访问自⼰ script 和之前的文档元素
- 当文档完成解析,document.readState 变成 interactive
- 所有 defer 脚本会按照在文档出现的顺序执行,延迟脚本能访问完整文档树, 禁止使用 document.write()
- 浏览器在 Document 对象上触发 DOMContentLoaded 事件
- 此时文档完全解析完成, 浏览器可能还在等待如图片等内容加载, 等这些内容完成载入 并且所有异步脚本完成载入和执行,document.readState 变为 complete,window 触发 load 事件
显示页面 (
HTML解析过程中会逐步显示页面)从浏览器接收 url 到开启⽹络请求线程 ( 这⼀部分可以展开浏览器的机制以及进程与线程 之间的关系)
开启⽹络线程到发出⼀个完整的 HTTP 请求 ( 这⼀部分涉及到 dns 查询, TCP/IP 请求, 五层因特⽹协议栈等知识)
从服务器接收到请求到对应后台接收到请求 ( 这⼀部分可能涉及到负载均衡, 安全拦截以 及后台内部的处理等等)
后台和前台的 HTTP 交互 ( 这⼀部分包括 HTTP 头部 、响应码 、报文结构 、 cookie 等知 识, 可以提下静态资源的 cookie 优化, 以及编码解码, 如 gzip 压缩等)
单独拎出来的缓存问题, HTTP 的缓存 ( 这部分包括 http 缓存头部, ETag , catch-control 等)
浏览器接收到 HTTP 数据包后的解析流程 ( 解析 html -词法分析然后解析成 dom 树 、解 析 css 生成 css 规则树 、合并成 render 树,然后 layout 、 painting 渲染 、复合图 层的合成 、 GPU 绘制 、外链资源的处理 、 loaded 和 DOMContentLoaded 等)
CSS 的可视化格式模型 ( 元素的渲染规则, 如包含块,控制框, BFC , IFC 等概念)
JS 引擎解析过程 ( JS 的解释阶段,预处理阶段,执⾏阶段生成执⾏上下文, VO ,作 用域链 、回收机制等等)
其它 ( 可以拓展不同的知识模块, 如跨域,web 安全, hybrid 模式等等内容)
5. 如何进行网站性能优化
content方面- 减少
HTTP请求:合并文件 、CSS精灵 、inline Image - 减少
DNS查询:DNS缓存 、将资源分布到恰当数量的主机名 - 减少
DOM元素数量
- 减少
Server方面- 使用
CDN - 配置
ETag - 对组件使用
Gzip压缩
- 使用
Cookie方面- 减⼩
cookie大⼩
- 减⼩
css方面- 将样式表放到页面顶部
- 不使用
CSS表达式 - 使用
<link>不使用@import
Javascript方面- 将脚本放到页面底部
- 将
javascript和css从外部引⼊ - 压缩
javascript和css - 减少
DOM访问
6. HTTP 状态码及其含义
1XX:信息状态码100Continue 继续,⼀ 般在发送 post 请求时, 已发送了 http header 之后服务端 将返回此信息,表示确认, 之后发送具体参数信息
2XX:成功状态码200OK 正常返回信息201Created 请求成功并且服务器创建了新的资源202Accepted 服务器已接受请求,但尚未处理
3XX:重定向301Moved Permanently 请求的网页已永久移动到新位置。302Found 临时性重定向。303See Other 临时性重定向,且总是使用 GET 请求新的 URI 。304Not Modified 自从上次请求后,请求的网页未修改过。
4XX:客户端错误400Bad Request 服务器⽆法理解请求的格式,客户端不应当尝试再次使用相同的内 容发起请求。401Unauthorized 请求未授权。403Forbidden 禁止访问。404Not Found 找不到如何与 URI 相匹配的资源。
5XX: 服务器错误500Internal Server Error 最常⻅的服务器端错误。503Service Unavailable 服务器端暂时⽆法处理请求 ( 可能是过载或维护) 。
7. 语义化的理解
- 用正确的标签做正确的事情!
HTML语义化就是让页面的内容结构化,便于对浏览器 、搜索引擎解析;- 在没有样式
CSS情况下也以⼀种⽂档格式显示, 并且是容易阅读的。 - 搜索引擎的爬虫依赖于标记来确定上下⽂和各个关键字的权重,利于
SEO。
8. 介绍⼀下你对浏览器内核的理解?
- 主要分成两部分:渲染引擎(
layoutengineer或RenderingEngine)和JS引擎 - 渲染引擎:负责取得网页的内容 (
HTML、XML、图像等等) 、整理讯息 (例如加⼊CSS等), 以及计算网页的显示⽅式,然后会输出至显示器或打印机 。浏览器的内核的不 同对于网页的语法解释会有不同,所以渲染的效果也不相同 。所有网页浏览器 、电子邮件 客户端以及其它需要编辑 、显示网络内容的应用程序都需要内核 JS引擎则:解析和执⾏javascript来实现网页的动态效果- 最开始渲染引擎和
JS引擎并没有区分的很明确,后来 JS 引擎越来越独立, 内核就倾向于 只指渲染引擎
9. html5 有哪些新特性、移除了那些元素?
HTML5现在已经不是SGML的子集, 主要是关于图像,位置,存储, 多任务等功能的增加- 绘画
canvas - 用于媒介回放的
video和audio元素 -本地离线存储localStorage长期存储数据, 浏览器关闭后数据不丢失 sessionStorage的数据在浏览器关闭后自动删除- 语意化更好的内容元素, 比如
article、footer、header、nav、section - 表单控件,
calendar、date、time、email、url、search - 新的技术
webworker、websocket、Geolocation
- 绘画
移除的元素:
- 纯表现的元素:
basefont、big、center、font、s、strike、tt、u - 对可用性产生负面影响的元素:
frame、frameset、noframes
- 纯表现的元素:
⽀持
HTML5新标签:IE8/IE7/IE6⽀持通过document.createElement⽅法产生的标签- 可以利用这⼀特性让这些浏览器⽀持
HTML5新标签 - 浏览器⽀持新标签后, 还需要添加标签默认的样式
当然也可以直接使用成熟的框架 、比如 html5shim
10. html5 的离线储存怎么使用, 工作原理能不能解释⼀下?
在用户没有与因特网连接时, 可以正常访问站点或应用,在用户与因特网连接时,更新用 户机器上的缓存文件
原理: HTML5 的离线存储是基于⼀个新建的 .appcache 文件的缓存机制(不是存储技 术), 通过这个文件上的解析清单离线存储资源, 这些资源就会像 cookie ⼀样被存储了下 来 。之后当网络在处于离线状态下时, 浏览器会通过被离线存储的数据进行页面展示
如何使用:
- 页面头部像下面⼀样加入⼀个
manifest的属性; - 在
cache.manifest文件的编写离线存储的资源 - 在离线状态时, 操作
window.applicationCache进行需求实现
- 页面头部像下面⼀样加入⼀个
js
CACHE MANIFEST
#v0.11
CACHE:
js/app.js
css/style.css
NETWORK:
resourse/logo.png
FALLBACK:
/offline.html11. 浏览器是怎么对 HTML5 的离线储存资源进行管理和加载的呢
- 在线的情况下, 浏览器发现
html头部有manifest属性, 它会请求manifest文件, 如 果是第⼀次访问app,那么浏览器就会根据 manifest 文件的内容下载相应的资源并且进行 离线存储 。如果已经访问过app并且资源已经离线存储了,那么浏览器就会使用离线的资 源加载页面,然后浏览器会对比新的manifest文件与旧的manifest文件, 如果文件没 有发生改变,就不做任何操作, 如果文件改变了,那么就会重新下载文件中的资源并进行 离线存储。 - 离线的情况下, 浏览器就直接使用离线存储的资源。
12. 请描述⼀下 cookies , sessionStorage 和 localStorage 的区别?
cookie是⽹站为了标示用户身份而储存在用户本地终端 ( Client Side)上的数据 ( 通常 经过加密)cookie数据始终在同源的http请求中携带 ( 即使不需要), 记会在浏览器和服务器间来回 传递sessionStorage和localStorage不会自动把数据发给服务器,仅在本地保存存储⼤小:
cookie数据⼤小不能超过4ksessionStorage和localStorage虽然也有存储⼤小的限制,但比cookie⼤得 多, 可以达到5M或更⼤
有期时间:
localStorage存储持久数据, 浏览器关闭后数据不丢失除⾮主动删除数据sessionStorage数据在当前浏览器窗⼝关闭后自动删除cookie设置的cookie过期时间之前⼀直有效, 即使窗⼝或浏览器关闭
13. iframe 有那些缺点?
iframe会阻塞主⻚⾯的Onload事件- 搜索引擎的检索程序无法解读这种⻚⾯,不利于
SEO iframe和主⻚⾯共享连接池, 而浏览器对相同域的连接有限制,所以会影响⻚⾯的并⾏ 加载- 使用
iframe之前需要考虑这两个缺点 。如果需要使用iframe, 最好是通过javascript动态给iframe添加src属性值, 这样可以绕开以上两个问题
14. WEB 标准以及 W3C 标准是什么?
标签闭合 、标签小写 、不乱嵌套 、使用外链 css 和 js 、结构⾏为表现的分离
15. xhtml 和 html 有什么区别?
⼀个是功能上的差别
- 主要是
XHTML可兼容各⼤浏览器 、手机以及PDA, 并且浏览器也能快速正确地编译⽹ ⻚
- 主要是
另外是书写习惯的差别
XHTML元素必须被正确地嵌套, 闭合, 区分大⼩写,文档必须拥有根元素
16. Doctype 作用? 严格模式与混杂模式如何区分? 它们有何意义?
- 页面被加载的时,
link会同时被加载, 而@imort页面被加载的时,link会同时被加 载, 而@import引用的CSS会等到页面被加载完再加载import只在IE5以上才能识 别, 而link是XHTML标签, 无兼容问题link方式的样式的权重 高于@import的权 重 <!DOCTYPE>声明位于文档中的最前面, 处于<html>标签之前 。告知浏览器的解析 器, 用什么文档类型 规范来解析这个文档- 严格模式的排版和
JS运作模式是 以该浏览器支持的最高标准运⾏ - 在混杂模式中, 页面以宽松的向后兼容的方式显示 。模拟老式浏览器的⾏为以防止站点无 法⼯作 。
DOCTYPE不存在或格式不正确会导致文档以混杂模式呈现
17. 行内元素有哪些?块级元素有哪些? 空(void)元素有那些?行内元素和块级元素有什么区别?
- ⾏内元素有:
abspanimginputselectstrong - 块级元素有:
divulollidldtddh1h2h3h4…p - 空元素:
<br><hr><img><input><link><meta> - ⾏内元素不可以设置宽高,不独占⼀⾏
- 块级元素可以设置宽高, 独占⼀⾏
18. HTML 全局属性(global attribute)有哪些
class:为元素设置类标识data-*: 为元素增加自定义属性draggable: 设置元素是否可拖拽id: 元素id,文档内唯⼀lang: 元素内容的的语⾔style: ⾏内css样式title: 元素相关的建议信息
19. Canvas 和 SVG 有什么区别?
svg绘制出来的每⼀个图形的元素都是独立的DOM节点, 能够方便的绑定事件或用来修 改 。canvas输出的是⼀整幅画布svg输出的图形是矢量图形,后期可以修改参数来自由放大缩⼩,不会失真和锯齿 。而canvas输出标量画布,就像⼀张图片⼀样,放大会失真或者锯齿
20. HTML5 为什么只需要写 <!DOCTYPE HTML>
HTML5不基于SGML, 因此不需要对DTD进⾏引用,但是需要doctype来规范浏览器 的⾏为- 而
HTML4.01基于SGML, 所以需要对类型DTD进⾏引用, 才能告知浏览器文档所使用的文档
21. 如何在页面上实现⼀个圆形的可点击区域?
svgborder-radius- 纯
js实现 需要求⼀个点在不在圆上简单算法 、获取鼠标坐标等等
22. 网页验证码是干嘛的, 是为了解决什么安全问题
- 区分用户是计算机还是⼈的公共全自动程序 。可以防止恶意破解密码 、刷票 、论坛灌水
- 有效防止黑客对某⼀个特定注册用户用特定程序暴⼒破解方式进⾏不断的登陆尝试
23. viewport
html
<meta
  name="viewport"
  content="width=device-width,initial-scale=1.0,minimum-scale=1.0,maximum-scale=1.0,user-scalable=0"
/>
// width 设置viewport宽度,为⼀个正整数,或字符串‘device-width’ // device-width
设备宽度 // height 设置viewport高度,⼀
般设置了宽度,会自动解析出高度,可以不用设置 // initial-scale 默认缩放比例
(初始缩放比例), 为⼀个数字,可以带⼩数 // minimum-scale
允许用户最⼩缩放比例,为⼀个数字,可以带⼩数 // maximum-scale
允许用户最大缩放比例,为⼀个数字,可以带⼩数 // user-scalable 是否允许手动缩放延伸提问
- 怎样处理 移动端
1px被 渲染成2px问题
- 怎样处理 移动端
局部处理
mate标签中的viewport属性 ,initial-scale设置为1rem按照设计稿标准走,外加利用transfrome的scale(0.5)缩⼩⼀倍即可;
全局处理
mate标签中的viewport属性 ,initial-scale设置为0.5rem按照设计稿标准走即可
24. 渲染优化
禁止使用
iframe( 阻塞父⽂档onload事件)iframe会阻塞主页面的Onload事件- 搜索引擎的检索程序⽆法解读这种页面,不利于
SEO iframe和主页面共享连接池, 而浏览器对相同域的连接有限制,所以会影响页面的并 行加载- 使用
iframe之前需要考虑这两个缺点 。如果需要使用iframe, 最好是通过javascript - 动态给
iframe添加src属性值, 这样可以绕开以上两个问题
禁止使用
gif图片实现loading效果 ( 降低CPU消耗,提升渲染性能)使用
CSS3代码代替JS动画 (尽可能避免重绘重排以及回流)对于⼀些⼩图标, 可以使用 base64 位编码, 以减少⽹络请求 。但不建议大图使用, 比较耗 费
CPU⼩图标优势在于:
- 减少
HTTP请求 - 避免⽂件跨域
- 修改及时生效
- 减少
页面头部的
<style></style><script></script>会阻塞页面;( 因为Renderer进程中JS线程和渲染线程是互斥的)页面中空的
href和src会阻塞页面其他资源的加载 (阻塞下载进程)⽹页
gzip,CDN托管,data缓存 , 图片服务器前端模板 1S+数据,减少由于
HTML标签导致的带宽浪费, 前端用变量保存 A1AX 请求结 果,每次操作本地变量,不用请求,减少请求次数用
innerHTML代替DOM操作,减少DOM操作次数,优化javascript性能当需要设置的样式很多时设置
className而不是直接操作style少用全局变量 、缓存
DOM节点查找的结果 。减少IO读取操作图片预加载,将样式表放在顶部,将脚本放在底部 加上时间戳
对普通的网站有⼀个统⼀的思路,就是尽量向前端优化 、减少数据库操作 、减少磁盘
IO
25. meta viewport 相关
html
<!DOCTYPE html>
<!--H5标准声明,使用 HTML5 doctype,不区分大⼩写-->
<head lang="”en”">
  <!--标准的 lang 属性写法-->
  <meta charset="’utf-8′" />
  <!--声明文档使用的字符编码-->
  <meta http-equiv="”X-UA-Compatible”" content="”IE" ="edge,chrome" ="1″" />
  <!--优先使
<meta name= ”description” content=”不超过150个字符”/> <!--页面描述-->
  <meta name="”keywords”" content="””" />
  <!-- 页面关键词-->
  <meta name="”author”" content="”name," email@gmail .com” />
  <!--网页作者-->
  <meta name="”robots”" content="”index,follow”" />
  <!--搜索引擎抓取-->
  <meta
    name="”viewport”"
    content="”initial-scale"
    ="1,"
    maximum-
    scale="3,"
    minimum-sc
    <meta
    name="”apple-mobile-web-app-title”"
    content="”标题”"
  />
  <!--iOS 设备 begin-- <meta name= ”apple-mobile-web-app-capable” content= ”yes”/> <!--添加到主屏后的标
是否启用 WebApp 全屏模式,删除苹果默认的⼯具栏和菜单栏-->
  <meta
    name="”apple-"
    itunes-
    app”
    content="”"
    app-
    id="myAppStoreID,"
    affiliate-data="<!--添加智能"
    App
    ⼴告条
    Smart
    App
    Banner
    (
    iOS
    6+
    Safari)
    --
  />
  <meta name="”apple-mobile-web-app-status-bar-style”" content="”black”" />
  <meta name="”format-detection”" content="”telphone" ="no," email="no”" />
  <!--设置苹果-->
  <meta name="”renderer”" content="”webkit”" />
  <!-- 启用360浏览器的极速模式(webkit)-->
  <meta http-equiv="”X-UA-Compatible”" content="”IE" ="edge”" />
  <!--避免IE使用兼容模-->
  <meta http-equiv="”Cache-Control”" content="”no-siteapp”" />
  <!--不让百度转码-->
  <meta name="”HandheldFriendly”" content="”true”" />
  <!--针对手持设备优化,主要是针对一些老的不识别viewport的浏览器,比如黑莓 -->
  <meta name="”MobileOptimized”" content="”320″" />
  <!--微软的老式浏览器-->
  <meta name="”screen-orientation”" content="”portrait”" />
  <!--uc强制竖屏-->
  <meta name="”x5-orientation”" content="”portrait”" />
  <!--QQ强制竖屏-->
  <meta name="”full-screen”" content="”yes”" />
  <!--UC强制全屏-->
  <meta name="”x5-fullscreen”" content="”true”" />
  <!--QQ强制全屏-->
  <meta name="”browsermode”" content="”application”" />
  <!--UC应用模式-->
  <meta name="”x5-page-mode”" content="”app”" />
  <!-- QQ应用模式-->
  <meta name="”msapplication-tap-highlight”" content="”no”" />
  <!--windows phone 设置页面不缓存-->
  <meta http-equiv="”pragma”" content="”no-cache”" />
  <meta http-equiv="”cache-control”" content="”no-cache”" />
  <meta http-equiv="”expires”" content="”0″" />
</head>26. 你做的页面在哪些流览器测试过?这些浏览器的内核分别是什么?
IE:trident内核Firefox:gecko内核Safari:webkit内核Opera:以前是presto内核,Opera现已改用 Google -Chrome的Blink内核Chrome:Blink(基于webkit, Google 与 Opera Software 共同开发)
27. div+css 的布局较 table 布局有什么优点?
- 改版的时候更⽅便 只要改
css⽂件。 - 页面加载速度更快 、结构化清晰 、页面显示简洁。
- 表现与结构相分离。
- 易于优化 (
seo) 搜索引擎更友好, 排名更容易靠前。
28. a: img 的 alt 与 title 有何异同?b:strong 与 em 的异同?
alt(alt text):为不能显示图像 、窗体或applets的用户代理 (UA),alt属性用 来指定替换⽂字 。替换⽂字的语⾔由lang属性指定 。(在 IE 浏览器下会在没有title时 把 alt 当成tooltip显示)title(tool tip):该属性为设置该属性的元素提供建议性的信息strong:粗体强调标签, 强调,表示内容的重要性em:斜体强调标签,更强烈强调,表示内容的强调点
29. 你能描述⼀下渐进增强和优雅降级之间的不同吗
渐进增强:针对低版本浏览器进⾏构建页面,保证最基本的功能,然后再针对高级浏览器 进⾏效果 、交互等改进和追加功能达到更好的用户体验
优雅降级:⼀开始就构建完整的功能,然后再针对低版本浏览器进⾏兼容
区别:优雅降级是从复杂的现状开始, 并试图减少用户体验的供给, 而渐进增强则是从⼀个非常基础的, 能够起作用的版本开始, 并不断扩充, 以适应未来环境的需要 。降级 (功能衰减) 意味着往回看;而渐进增强则意味着朝前看,同时保证其根基处于安全地带
30. 为什么利用多个域名来存储网站资源会更有效?
CDN缓存更⽅便- 突破浏览器并发限制
- 节约
cookie带宽 - 节约主域名的连接数,优化页面响应速度
- 防止不必要的安全问题
31. 简述⼀下 src 与 href 的区别
src用于替换当前元素, href 用于在当前⽂档和引用资源之间确立联系。src是source的缩写,指向外部资源的位置,指向的内容将会嵌⼊到⽂档中当前标签所 在位置;在请求src资源时会将其指向的资源下载并应用到⽂档内,例如js脚本,img图片和frame等元素<script src ="js.js"></script>当浏览器解析到该元素时,会暂停其他资源的下载和处理, 直到将该资源加载 、编译 、执⾏完毕, 图片和框架等元素也如此, 类似于将所指向资源嵌⼊当前标签内 。这也是为什么将 js 脚本放在底部而不是头部href是Hypertext Reference的缩写,指向⽹络资源所在位置, 建立和当前元素 ( 锚 点) 或当前⽂档 (链接) 之间的链接, 如果我们在⽂档中添加<link href="common.css" rel="stylesheet"/>那么浏览器会识别该⽂档为css⽂ 件,就会并⾏下载资源并且不会停止对当前⽂档的处理 。这也是为什么建议使用link⽅ 式来加载css, 而不是使用@import⽅式
32. 知道的网页制作会用到的图片格式有哪些?
png-8、png-24、jpeg、gif、svg但是上面的那些都不是面试官想要的最后答案 。面试官希望听到是 Webp , Apng 。 ( 是否有关注新技术,新鲜事物)
- Webp:
WebP格式,谷歌 ( google) 开发的⼀种旨在加快图片加载速度的图片格式 。图 片压缩体积大约只有JPEG的2/3, 并能节省大量的服务器带宽资源和数据空间。Facebook Ebay等知名⽹站已经开始测试并使用WebP格式 - 在质量相同的情况下, WebP 格式图像的体积要比 JPEG 格式图像⼩
40%。 - Apng:全称是
“Animated Portable Network Graphics”, 是 PNG 的位图动画扩展, 可 以实现 png 格式的动态图片效果 。04 年诞生,但⼀直得不到各大浏览器⼚商的⽀持, 直到 ⽇前得到iOS safari 8的⽀持,有望代替GIF成为下⼀代动态图标准
33. 在 css/js 代码上线之后开发人员经常会优化性能,从用户刷新网页开始, ⼀次 js 请求⼀般情况下有哪些地方会有缓存处理?
dns 缓存, 浏览器缓存, 服务器缓存
34. ⼀个页面上有大量的图片 (大型电商网站) ,加载很慢,你有哪些方法优化这些图片的加载,给用户更好的体验。
- 图片懒加载,在页面上的未可视区域可以添加⼀个滚动事件, 判断图片位置与浏览器顶端 的距离与页面的距离, 如果前者小于后者,优先加载。
- 如果为幻灯片 、相册等, 可以使用图片预加载技术,将当前展示图片的前⼀张和后⼀张优 先下载。
- 如果图片为 css 图片, 可以使用 CSSsprite , SVGsprite , Iconfont 、 Base64 等技 术。
- 如果图片过大, 可以使用特殊编码的图片,加载时会先加载⼀张压缩的特别厉害的缩略 图, 以提高用户体验。
- 如果图片展示区域小于图片的真实大小,则因在服务器端根据业务需要先行进行图片压 缩, 图片压缩后大小与展示⼀致。
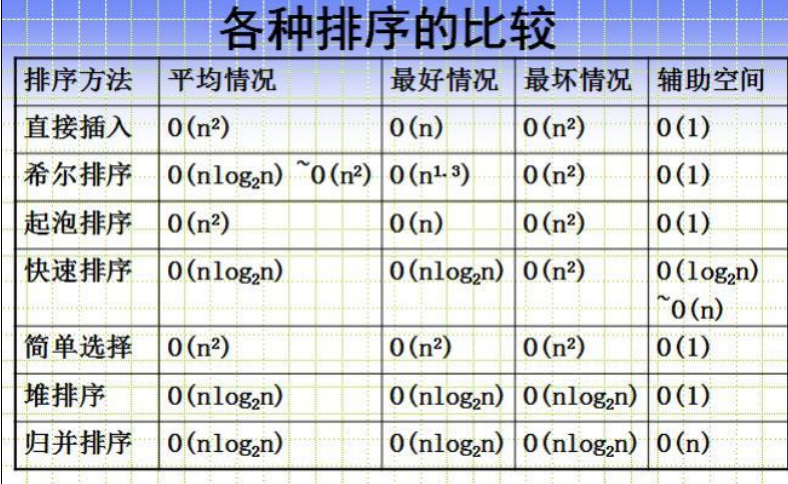
35. 常见排序算法的时间复杂度,空间复杂度
36. web 开发中会话跟踪的方法有哪些
cookiesessionurl重写- 隐藏
input ip地址
37. HTTP request 报文结构是怎样的
- 首行是 Request-Line 包括:请求方法,请求 URI,协议版本, CRLF
- 首行之后是若干行请求头, 包括 general-header, request-header 或者 entity-header, 每个⼀行以 CRLF 结束
- 请求头和消息实体之间有⼀个 CRLF 分隔
- 根据实际请求需要可能包含⼀个消息实体 ⼀个请求报文例子如下:
js
GET /Protocols/rfc2616/rfc2616-sec5.html HTTP/1.1
Host: www.w3.org
Connection: keep-alive
Cache-Control: max-age=0
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/ *;q=0.8,application/signed-exchange;v=b3
user-agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36
Referer: https//www.google.com.hk/
Accept-Encoding: gzip,deflate,sdch
Accept-Language: zh-CN,zh;q=0.8,en;q=0.6
Cookie: authorstyle=yes
If-None-Match: "2cc8-3e3073913b100"
If-Modified-Since: Wed, 01 Sep 2004 13:24:52 GMT
name=qiu&age=2538. HTTP response 报文结构是怎样的
js
HTTP/1.1 200 OK
Date: Tue, 08 Jul 2014 05:28:43 GMT
Server: Apache/2
Last-Modified: Wed, 01 Sep 2004 13:24:52 GMT
ETag: "40d7-3e3073913b100"
Accept-Ranges: bytes
Content-Length: 16599
Cache-Control: max-age=21600
Expires: Tue, 08 Jul 2014 11:28:43 GMT
P3P: policyref="http://www.w3.org/2001/05/P3P/p3p.xml"
Content-Type: text/html; charset=iso-8859-1
{"name": "qiu", "age": 25}